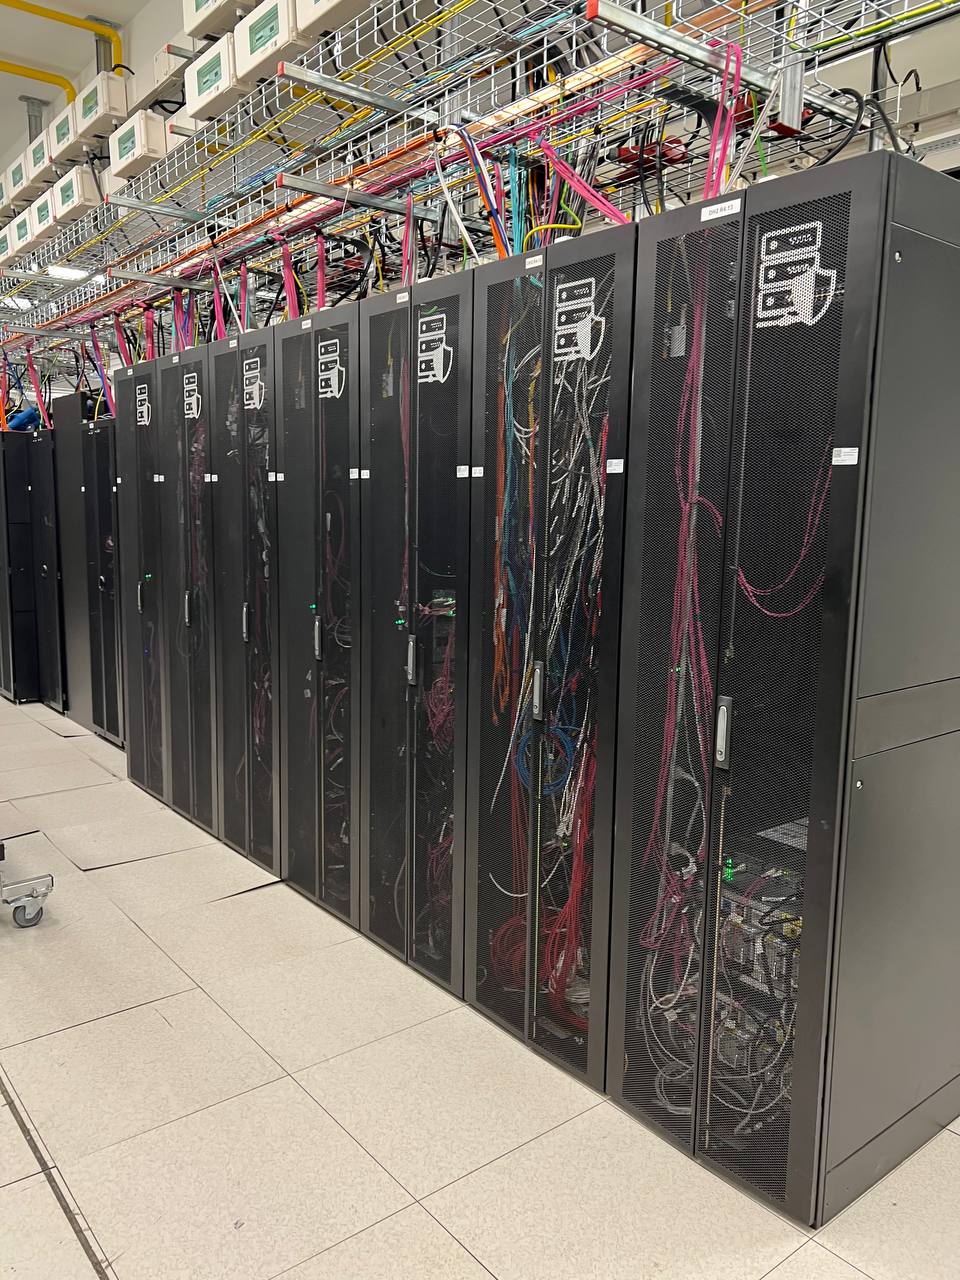
Wer sicherstellen will, dass sein System unter echten Ausfallbedingungen funktioniert, muss es unter echten Ausfallbedingungen testen. Das ist die Grundidee hinter Chaos Engineering – einem Ansatz, der durch Netflix und Amazon bekannt wurde und sich mittlerweile in SRE-Teams auf der ganzen Welt etabliert hat. 2026 verändert der Einzug von KI in dieses Feld die Praxis grundlegend.
Bildquelle: Pixabay (pixabay.com) – Lizenz: Pixabay Content License
Was ist Chaos Engineering?
Chaos Engineering bezeichnet die Praxis, kontrollierte Störungen in Produktions- oder produktionsnahe Systeme einzubringen, um Schwachstellen zu finden, bevor echte Ausfälle sie aufdecken. Dabei werden gezielt Fehler injiziert: Ein Service wird abgestürzt, ein Netzwerkpfad unterbrochen, eine Datenbank künstlich verlangsamt oder eine Abhängigkeit entfernt. Das Ziel ist nicht Chaos um des Chaos willen, sondern das Aufdecken von verborgenen Schwachstellen unter kontrollierten Bedingungen.
Der klassische Prozess folgt einem wissenschaftlichen Ansatz: Hypothese aufstellen, Experiment definieren, Ergebnis messen, Erkenntnisse ableiten. Das setzt voraus, dass Teams wissen, was sie testen wollen – und dass sie die Auswirkungen ihrer Experimente sauber messen können.
Die Herausforderungen klassischer Chaos-Experimente
In der Praxis stoßen Teams schnell auf drei Probleme:
- Mangelnde Systematik: Wer entscheidet, welches Szenario als Nächstes getestet wird? Ohne klare Priorisierung werden häufig dieselben, bereits bekannten Szenarien wiederholt.
- Aufwändige Analyse: Die Auswertung eines Chaos-Experiments erfordert das Korrelieren von Metriken aus Monitoring, Logs und Traces. Das kostet Zeit und setzt tiefes Systemwissen voraus.
- Fehlende Abdeckung: Komplexe, verteilte Systeme haben unzählige mögliche Fehlerpunkte. Manuell lassen sich nur ein Bruchteil davon testen.
KI als Katalysator im Chaos Engineering
2026 beginnen SRE-Teams, KI-Systeme in ihren Chaos-Engineering-Prozess zu integrieren – und das verändert alle drei der genannten Problembereiche.
Intelligente Szenarienauswahl: KI-Modelle analysieren historische Incident-Daten, aktuelle Abhängigkeitsgraphen und bekannte Schwachstellenmuster, um die Chaos-Experimente zu priorisieren, die am wahrscheinlichsten neue Erkenntnisse liefern. Statt zufällig oder intuitiv zu testen, arbeiten Teams datengetrieben.
Automatisierte Auswertung: Nach einem Experiment korreliert das KI-System automatisch alle relevanten Metriken aus Monitoring, Logging und Tracing. Es erstellt einen strukturierten Bericht: Welche Services waren betroffen? Wie hat sich die Latenz verändert? Wurde der Alert ausgelöst? Wurde der Runbook ausgeführt? Diese Zusammenfassung reduziert den manuellen Analyseaufwand erheblich.
Kombinatorische Testabdeckung: KI-Systeme können Kombinationen von Fehlern systematisch durchprobieren – etwa: Was passiert, wenn gleichzeitig ein Service langsam reagiert UND ein Cache nicht erreichbar ist? Diese kombinierten Szenarien sind es, die in der Praxis echte Ausfälle verursachen, aber selten im manuellen Test abgedeckt werden.
Integration mit Monitoring und Alerting
Chaos Engineering entfaltet seinen vollen Wert nur, wenn es eng mit dem Monitoring-Stack verzahnt ist. Die Kernannahme lautet: Wenn ich einen Fehler erzeuge, muss mein Monitoring-System ihn erkennen und mein Alerting-System ihn eskalieren.
Ein typischer Test sieht so aus: Der Chaos-Agent stoppt einen Service. Erkennt der Uptime-Monitor den Ausfall? Schlägt der Heartbeat-Check an? Wird die Statusseite automatisch aktualisiert? Erhält der On-Call-Engineer innerhalb der definierten SLA eine Benachrichtigung?
Wenn einer dieser Schritte ausbleibt, ist das Ergebnis des Experiments wertvoller als die Bestätigung, dass alles funktioniert. Es zeigt eine blinde Stelle im Monitoring – eine Lücke, die bei einem echten Ausfall zur stillen Eskalation führen würde. FreshCore-Monitore, Heartbeats und Notification-Handler lassen sich gezielt in solche Testszenarien integrieren, um die End-to-End-Reaktionskette zu validieren.
GameDays: Strukturierte Chaos-Übungen für Teams
Neben automatisierten Chaos-Experimenten setzen erfahrene SRE-Teams auf sogenannte GameDays – strukturierte Übungstage, an denen das gesamte Team ein simuliertes Szenario durchspielt. Ein Fehlerszenario wird aktiviert, das Team versucht zu diagnostizieren und zu beheben, ohne vorab über Art und Ort des Problems informiert zu werden.
KI-Assistenz kann dabei in der Nachbereitung wertvolle Dienste leisten: Sie analysiert, welche Diagnoseschritte das Team unternommen hat, wo Verzögerungen entstanden sind und welche Informationen gefehlt haben. Aus diesen Erkenntnissen lassen sich Runbooks verbessern, Dashboards anpassen und Monitoring-Konfigurationen schärfen.
Praktische Empfehlungen für den Einstieg
- Klein anfangen: Beginne mit einzelnen, nicht-kritischen Services in einer Staging-Umgebung. Erst wenn Prozesse und Tools etabliert sind, in die Produktion wechseln.
- Hypothesen dokumentieren: Jedes Experiment braucht eine klare Hypothese: „Wenn Service X ausfällt, übernimmt Service Y automatisch und die Latenz steigt um maximal 200ms."
- Blast Radius begrenzen: Chaos-Experimente müssen einen definierten Scope haben. Niemals unbegrenzt Fehler injizieren, ohne Stopp-Bedingungen definiert zu haben.
- Monitoring zuerst prüfen: Bevor ein Chaos-Experiment startet, sicherstellen, dass Monitoring und Alerting korrekt konfiguriert sind. Andernfalls fehlt die Messbasis.
- Ergebnisse kommunizieren: Die Erkenntnisse aus Chaos-Experimenten gehören in das Team-Wissen und in die Runbooks – nicht nur in einen Bericht, der nie gelesen wird.
Chaos Engineering als kontinuierliche Praxis
Der entscheidende Unterschied zwischen Teams, die Chaos Engineering wirklich nutzen, und solchen, die es nur einmalig ausprobieren: Erstere machen es zu einem kontinuierlichen Prozess. Ähnlich wie Unit-Tests Teil des Entwicklungsprozesses sind, werden Chaos-Experimente Teil des Betriebsprozesses.
KI unterstützt diese Kontinuität: Sie schlägt neue Experimente vor, wenn neue Services deployt werden, wenn sich Abhängigkeiten ändern oder wenn aus Incidents neue Risikoprofile entstehen. So bleibt Chaos Engineering aktuell und relevant – statt als einmaliges Projekt zu verpuffen.
Wer 2026 in Systemresilienz investiert, kommt an Chaos Engineering nicht vorbei. Und wer Chaos Engineering mit KI-Unterstützung betreibt, hat die Werkzeuge, um schneller, gezielter und nachhaltiger stabile Systeme zu bauen.
Quellen:
- Principles of Chaos Engineering (principlesofchaos.org)
- Google SRE Workbook: „Testing for Reliability"
- Chaos Toolkit Dokumentation (chaostoolkit.org)
- AWS: „Chaos Engineering on AWS" (Whitepaper 2025)