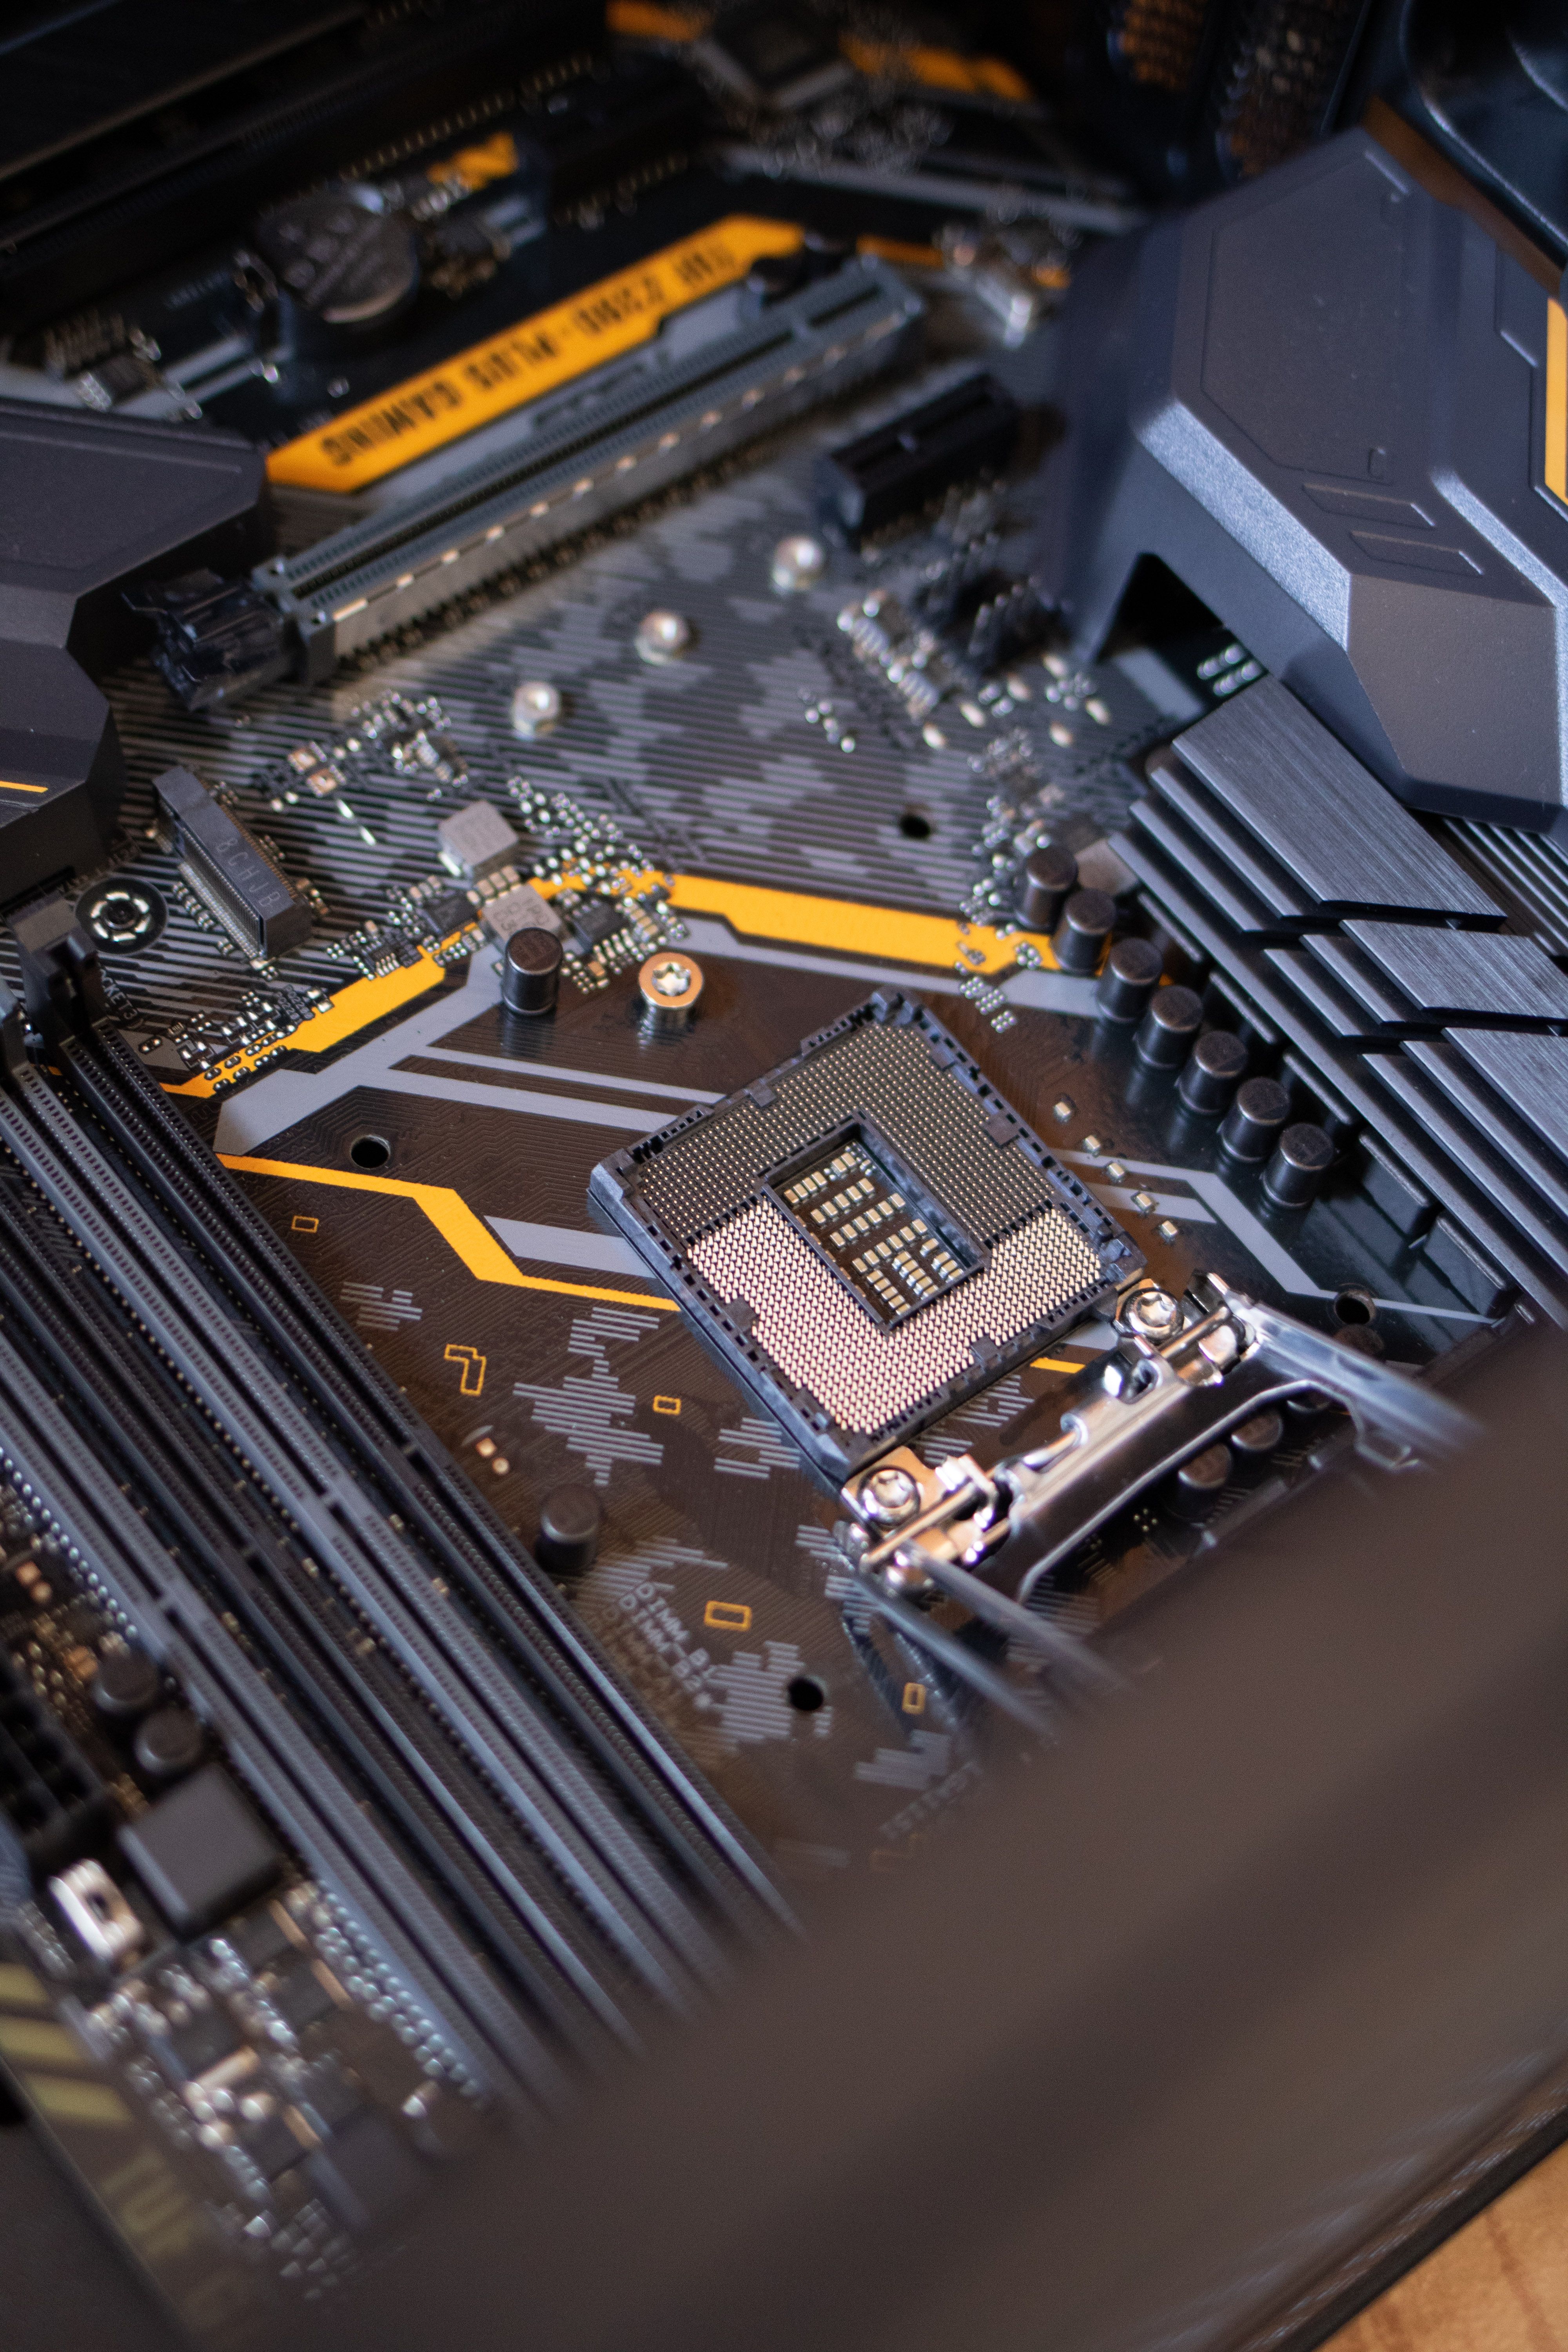
Neue Chip-Generationen verändern das KI-Betriebsumfeld grundlegend
Der Herbst 2026 steht im Zeichen einer neuen Hardware-Generation, die den Betrieb von KI-Infrastruktur nicht nur schneller, sondern grundlegend anders macht. NVIDIA hat mit der Blackwell-Ultra-Architektur und AMD mit der Instinct-MI350-Serie Prozessoren vorgestellt, deren Leistungsdichte bisherige Maßstäbe verschiebt. Gleichzeitig rücken Energieeffizienz und thermisches Management in den Mittelpunkt – denn wer KI-Workloads im Rechenzentrum betreibt, spürt die Auswirkungen direkt in der Betriebskostenabrechnung.
Für IT-Teams ist das keine abstrakte Chiparchitektur-Diskussion. Es geht um konkrete Entscheidungen: Welche Infrastruktur eignet sich für welche KI-Workloads? Wie verändern sich Monitoring-Anforderungen, wenn ein einziger GPU-Knoten mehrere hundert Teraflops liefert? Und wie wirken sich neue Speicher-Hierarchien auf den täglichen Betrieb aus? Dieser Artikel gibt einen praxisorientierten Überblick über das, was die neue Hardware-Generation für IT-Teams konkret bedeutet.
NVIDIA Blackwell Ultra: Was sich konkret ändert
Die Blackwell-Ultra-Generation (B200 Ultra) bringt im Vergleich zu Hopper-basierten Systemen vor allem drei relevante Änderungen für den IT-Betrieb mit sich:
- NVLink 5.0: Die Interconnect-Bandbreite zwischen GPUs steigt erheblich, was Multi-GPU-Setups für Inferenz-Aufgaben praxistauglicher macht. Modelle, die bisher auf den Arbeitsspeicher mehrerer Karten verteilt werden mussten, lassen sich kohärenter betreiben, ohne dass Datentransfer zwischen den Knoten zum Flaschenhals wird.
- HBM3e-Speicher mit erweiterter Kapazität: Größere GPU-Speicher bedeuten, dass mehr Modellparameter direkt im VRAM gehalten werden können. Das reduziert Latenzspitzen, die bei Speicher-Swapping entstehen.
- Höhere TDP, veränderte Kühlanforderungen: Die gestiegene Leistungsaufnahme macht Flüssigkühlung in Hyperscale-Umgebungen fast obligatorisch. Für Colocation-Rechenzentren ohne Direktwasserkühlung entstehen neue Kapazitätsgrenzen, die Investitionen in die Kühlung nötig machen, bevor neue Hardware installiert werden kann.
Für Teams, die NVIDIA-H100-Cluster betreiben und einen Upgrade-Pfad planen, bedeutet das: Die Umstellung ist nicht nur eine Hardware-Beschaffungsfrage, sondern eine umfassende Infrastrukturplanung – inklusive Kühlung, Stromversorgung, Rack-Dichte und Netzwerk-Topologie. Das sollte frühzeitig in die Jahresplanung einfließen.
AMD Instinct MI350: Ernsthafte Alternative mit wachsendem Ökosystem
AMD positioniert die Instinct-MI350-Serie konsequent als Alternative zu NVIDIA – insbesondere für Teams, die nicht vollständig in das CUDA-Ökosystem eingebunden sind oder eine Diversifizierung ihrer Lieferkette anstreben. ROCm als offene Softwareplattform hat in den letzten Jahren erheblich an Reife gewonnen. Die Unterstützung durch populäre KI-Frameworks wie PyTorch und JAX ist inzwischen solide, auch wenn einige CUDA-spezifische Bibliotheken noch keine vollständige ROCm-Entsprechung haben.
Relevant für den IT-Betrieb ist, dass AMD-Karten durch das CDNAv4-Design eine andere Speicherarchitektur mitbringen. Das Unified Memory Model vereinfacht bestimmte Workload-Typen, erfordert aber auch ein Umdenken bei der Speicherverwaltung und im Monitoring. Wer bislang NVIDIA-spezifische Monitoring-Tools wie nvidia-smi oder DCGM eingesetzt hat, muss für AMD-Infrastruktur auf ROCm-SMI und entsprechende Prometheus-Exporter umstellen.
Wer heute KI-Infrastruktur beschafft, trifft eine Entscheidung auf Jahre hinaus – nicht nur über Rechenleistung, sondern über Softwareabhängigkeiten, Monitoring-Tooling und Supportverträge.
Was die neue Hardware für Monitoring und Betrieb bedeutet
Neue GPU-Generationen bringen neue Metriken und neue Fehlerbilder. Teams, die bisher vor allem CPU- und RAM-Auslastung überwacht haben, stehen vor erweiterten Anforderungen:
- GPU-Temperatur und thermisches Throttling: Bei hohen Auslastungsspitzen ist Überhitzung ein reales Betriebsproblem. Monitoring-Systeme müssen GPU-Thermalwerte in ihre Alerting-Logik einbeziehen – mit Schwellenwerten, die frühzeitig auf drohende Throttling-Situationen hinweisen.
- NVLink- und Interconnect-Gesundheit: Fehler auf Interconnect-Ebene sind schwerer zu erkennen als Knotenausfälle. Multi-GPU-Trainingsläufe können bei schleichendem NVLink-Fehler korrumpierte Ergebnisse liefern, ohne offensichtlichen Ausfall. Regelmäßige Diagnosen der Interconnect-Topologie sind daher keine optionale Maßnahme.
- VRAM-Auslastung und Speicherfragmentierung: Langläufer-Prozesse in Inferenz-Clustern können über Zeit Speicher fragmentieren. Regelmäßige VRAM-Überprüfungen und geplante Neustarts der Inferenz-Dienste sollten Teil des operativen Regimes sein.
- Power Draw vs. Budget: Rechenzentren mit festen Leistungsbudgets pro Rack müssen die GPU-Leistungsaufnahme in ihre Kapazitätsplanung einrechnen. Power Capping wird für viele Teams zu einem Standardwerkzeug.
Edge AI: Kleinere Chips, andere Anforderungen
Neben den Hyperscale-Chips wächst auch der Markt für Edge-Inferenz-Hardware erheblich. NVIDIA Jetson Orin NX und ähnliche ARM-basierte Beschleuniger ermöglichen KI-Inferenz ohne Rechenzentrumsanbindung. Für IT-Teams, die IoT-Infrastruktur oder verteilte Außenstellen betreiben, entstehen damit neue Deployment-Muster mit eigenen Betriebsherausforderungen:
- Modelle werden lokal auf Edge-Knoten ausgeführt, was Netzwerklatenz und Datenschutzrisiken reduziert – aber auch neue Risiken bei Geräteausfällen und veralteter Software mitbringt.
- Das Fleet-Management dieser Knoten – Software-Updates, Monitoring, Ferndiagnose und Fehlerbehandlung – erfordert eigene Tooling-Investitionen, die sich von klassischem Server-Monitoring unterscheiden.
- Firmware- und Treiber-Updates auf Edge-Hardware müssen sorgfältig koordiniert werden, um Kompatibilitätsbrüche mit laufenden Modellen zu vermeiden.
Kostenstruktur: Strom und Kühlung oft teurer als die Hardware
Die Diskussion um KI-Hardware dreht sich 2026 nicht mehr nur um Teraflops pro Dollar. Strom, Kühlung und Personalaufwand für den Betrieb sind in vielen Organisationen inzwischen dominante Kostenfaktoren. Das führt zu strategischen Abwägungen:
- Cloud-Instanzen mit neuester GPU-Hardware erlauben den Zugriff auf Blackwell-Infrastruktur ohne eigene Beschaffung – allerdings mit variablen Betriebskosten, die bei intensiver Nutzung schnell höher liegen als On-Premises-Alternativen.
- On-Premises-Cluster sind für vorhersehbare Dauerlast langfristig häufig günstiger, erfordern aber Investitionen in Stromversorgung, Kühlung und Betriebspersonal.
- Hybridmodelle – eigene Hardware für die Grundlast, Cloud-Kapazität für Spitzen – setzen sich in mittelgroßen IT-Organisationen zunehmend durch.
Fazit: Hardware-Entwicklung als strategische IT-Entscheidung
Die neue Chip-Generation von NVIDIA und AMD ist mehr als ein Leistungsupdate. Sie bringt veränderte Betriebsanforderungen, neue Monitoring-Dimensionen und Entscheidungen über Lieferketten-Diversifizierung mit sich. IT-Teams tun gut daran, Hardware-Roadmaps aktiv zu verfolgen – nicht weil jeder sofort upgraden muss, sondern weil Infrastrukturentscheidungen von heute die Betriebsrealität der nächsten Jahre prägen.
Besonders wichtig: Wer jetzt KI-Monitoring-Strukturen aufbaut, sollte diese von Anfang an auf GPU-Metriken, Interconnect-Gesundheit und thermische Überwachung auslegen. Nachrüsten bei komplexer KI-Infrastruktur ist aufwendiger als vorausplanen.
Bildquelle: Pexels (Foto: Pixabay) – Serverrack-Infrastruktur als Symbol für moderne KI-Hardware-Umgebungen.
Quellen
- NVIDIA Blackwell-Architektur-Überblick (nvidia.com)
- AMD Instinct MI350 Produktinformationen (amd.com)
- ROCm Open Software Platform (rocm.docs.amd.com)




