Die klassische Root-Cause-Analyse: Gut, aber langsam
Wenn ein Produktionssystem ausfällt, zählt jede Minute. Die klassische Vorgehensweise bei der Root-Cause-Analyse (RCA) – manuelle Log-Auswertung, iteratives Hypothesenbilden, schrittweise Eingrenzung durch erfahrene Engineers – ist methodisch solide, aber zeitintensiv. In komplexen verteilten Systemen mit Dutzenden von Microservices, verschachtelten Abhängigkeiten und Millionen von Log-Zeilen pro Stunde kann allein das initiale Sichten relevanter Daten Stunden in Anspruch nehmen.
Seit Ende 2025 gewinnt ein anderer Ansatz deutlich an Bedeutung: KI-gestützte Root-Cause-Analyse, bei der Large Language Models (LLMs) in Verbindung mit strukturierten Diagnosepipelines die Analyse von Störungen automatisieren und in einem Bruchteil der bisherigen Zeit zu belastbaren Hypothesen kommen.
Wie KI-gestützte RCA in der Praxis funktioniert
Der Ansatz kombiniert mehrere Komponenten, die eng zusammenwirken müssen, um effektiv zu sein:
1. Strukturierte Datenerfassung
Ein LLM kann nur dann hilfreich sein, wenn es die richtigen Daten bekommt. Der erste Schritt ist daher die automatische Aggregation relevanter Signale zum Zeitpunkt des Incidents:
- Fehler-Logs aus dem betroffenen Zeitfenster (mit Fokus auf Error- und Warning-Level)
- Metrik-Ausschläge kurz vor dem Incident (CPU, Speicher, Netzwerklatenz, Fehlerrate)
- Deployment-Events und Konfigurationsänderungen der letzten 24–72 Stunden
- Topologieinformationen: Welche Services hängen voneinander ab?
Dieser Kontext wird als strukturiertes Prompt an das Modell übergeben, zusammen mit einer klaren Aufgabenbeschreibung: Das Modell soll Ursachenhypothesen in absteigender Wahrscheinlichkeit generieren und dabei die Herkunft jeder Hypothese aus dem vorliegenden Datenmaterial begründen.
2. Hypothesenbildung und Priorisierung
Ein gut konfiguriertes LLM ist in der Lage, aus unstrukturierten Log-Daten Muster zu erkennen, die für einen Menschen erst nach intensivem Durchsuchen sichtbar wären. Typische Erkenntnisse, die automatisiert auftauchen:
- Zeitliche Korrelationen: „3 Minuten vor dem ersten Fehler wurde Service X deployed, der eine Bibliothek in Version Y verwendet."
- Kaskadenfehler: „Service A hat begonnen, Timeouts zu werfen, genau als Service B seine Connection-Pool-Limits erreicht hat."
- Wiederholungsmuster: „Dieser Fehlertyp trat bereits am 12. und 19. Oktober auf – jeweils zu ähnlichen Uhrzeiten."
3. Iterative Verfeinerung durch Follow-up-Abfragen
Die erste Hypothese ist selten die letzte. Moderne Agentic-Setups ermöglichen es, dass das System nach der initialen Analyse gezielt weitere Daten anfordert: Zusätzliche Log-Zeitfenster, Detaillogs aus spezifischen Services, oder historische Metrik-Zeitreihen. So entsteht ein iterativer Diagnoseprozess, der einem erfahrenen On-Call-Engineer ähnelt – nur deutlich schneller.
Grenzen und Stolpersteine
KI-gestützte RCA ist kein Allheilmittel. Es gibt klar definierte Schwachstellen, die Teams kennen müssen:
Datenqualität entscheidet alles
Ein LLM kann nur mit dem arbeiten, was ihm übergeben wird. Schlecht strukturierte Logs, fehlende Metadaten oder unvollständige Tracing-Daten führen zu unpräzisen oder falschen Hypothesen. Investitionen in gutes Log-Format und vollständiges Tracing zahlen sich bei KI-gestützter Analyse doppelt aus.
Konfidenz ≠ Korrektheit
LLMs formulieren Hypothesen häufig zuversichtlich klingend, auch wenn die Datenbasis dünn ist. Ein gutes RCA-System sollte immer eine Konfidenzangabe und eine Begründung mitliefern – und das On-Call-Team sollte trainiert sein, diese kritisch zu bewerten statt blind zu folgen.
Neue Fehlerklassen erfordern neues Wissen
Wenn ein Fehler durch eine Bibliothek entsteht, die erst letzte Woche veröffentlicht wurde, hat das Modell möglicherweise keine ausreichenden Trainingsdaten dazu. In solchen Fällen ist der Mehrwert begrenzt und menschliche Expertise unersetzlich.
Integration in bestehende Incident-Response-Workflows
Der Einsatz von KI in der RCA funktioniert am besten als Ergänzung zu bestehenden Prozessen, nicht als Ersatz. Bewährte Integrationspunkte sind:
- Automatische Erstanalyse beim Alert: Sobald ein kritischer Alert ausgelöst wird, startet die KI-Pipeline automatisch und hat beim ersten Menschenkontakt bereits eine initiale Hypothesenliste bereit.
- Unterstützung beim Postmortem: Nach Abschluss des Incidents hilft das System dabei, die Ereignischronologie zu rekonstruieren und Muster über mehrere vergangene Incidents hinweg zu identifizieren.
- Runbook-Vorschläge: Basierend auf der erkannten Ursache kann das System passende Runbook-Schritte vorschlagen oder direkt verlinken.
Tooling und Architektur in 2026
Für Teams, die eine eigene KI-gestützte RCA-Pipeline aufbauen wollen, hat sich folgende Architektur als praktisch erwiesen:
Ein zentraler Observability-Stack (Prometheus, Loki, Jaeger o.ä.) stellt die Rohdaten bereit. Eine Pipeline-Komponente aggregiert bei Alert-Auslösung automatisch relevante Daten, formatiert sie als strukturierten Kontext und übergibt diesen an ein LLM via API. Das Modell gibt eine strukturierte Ausgabe (Hypothesen, Konfidenz, nächste Diagnoseschritte) zurück, die in das Incident-Management-Tool oder direkt in den Alert-Thread eingespeist wird.
Für Teams, die keine eigene Pipeline aufbauen wollen, gibt es zunehmend kommerzielle Lösungen, die diese Architektur als fertiges Produkt anbieten. Der Auswahlprozess sollte dabei die Datenschutzanforderungen des eigenen Unternehmens berücksichtigen – Log-Daten enthalten häufig sensible Informationen, die nicht beliebig an externe APIs übermittelt werden dürfen.
Fazit: KI als Erstresponder in der Störungsanalyse
KI-gestützte Root-Cause-Analyse verändert, wie IT-Teams mit Incidents umgehen. Nicht weil sie menschliche Expertise ersetzt, sondern weil sie die zeitintensivste Phase – das initiale Sichten und Einordnen von Daten – drastisch beschleunigt. Ein Ansatz, der vor allem in komplexen verteilten Systemen seine Stärken ausspielt, ist heute mit den verfügbaren LLMs bereits produktionsreif umsetzbar.
Teams, die früh investieren, bauen gleichzeitig wertvolles internes Know-how auf: Welche Daten braucht das Modell? Wie validiere ich Hypothesen effizient? Wie integriere ich RCA-Ergebnisse in meine bestehenden Prozesse? Diese Fragen lassen sich nur durch praktische Erfahrung beantworten.
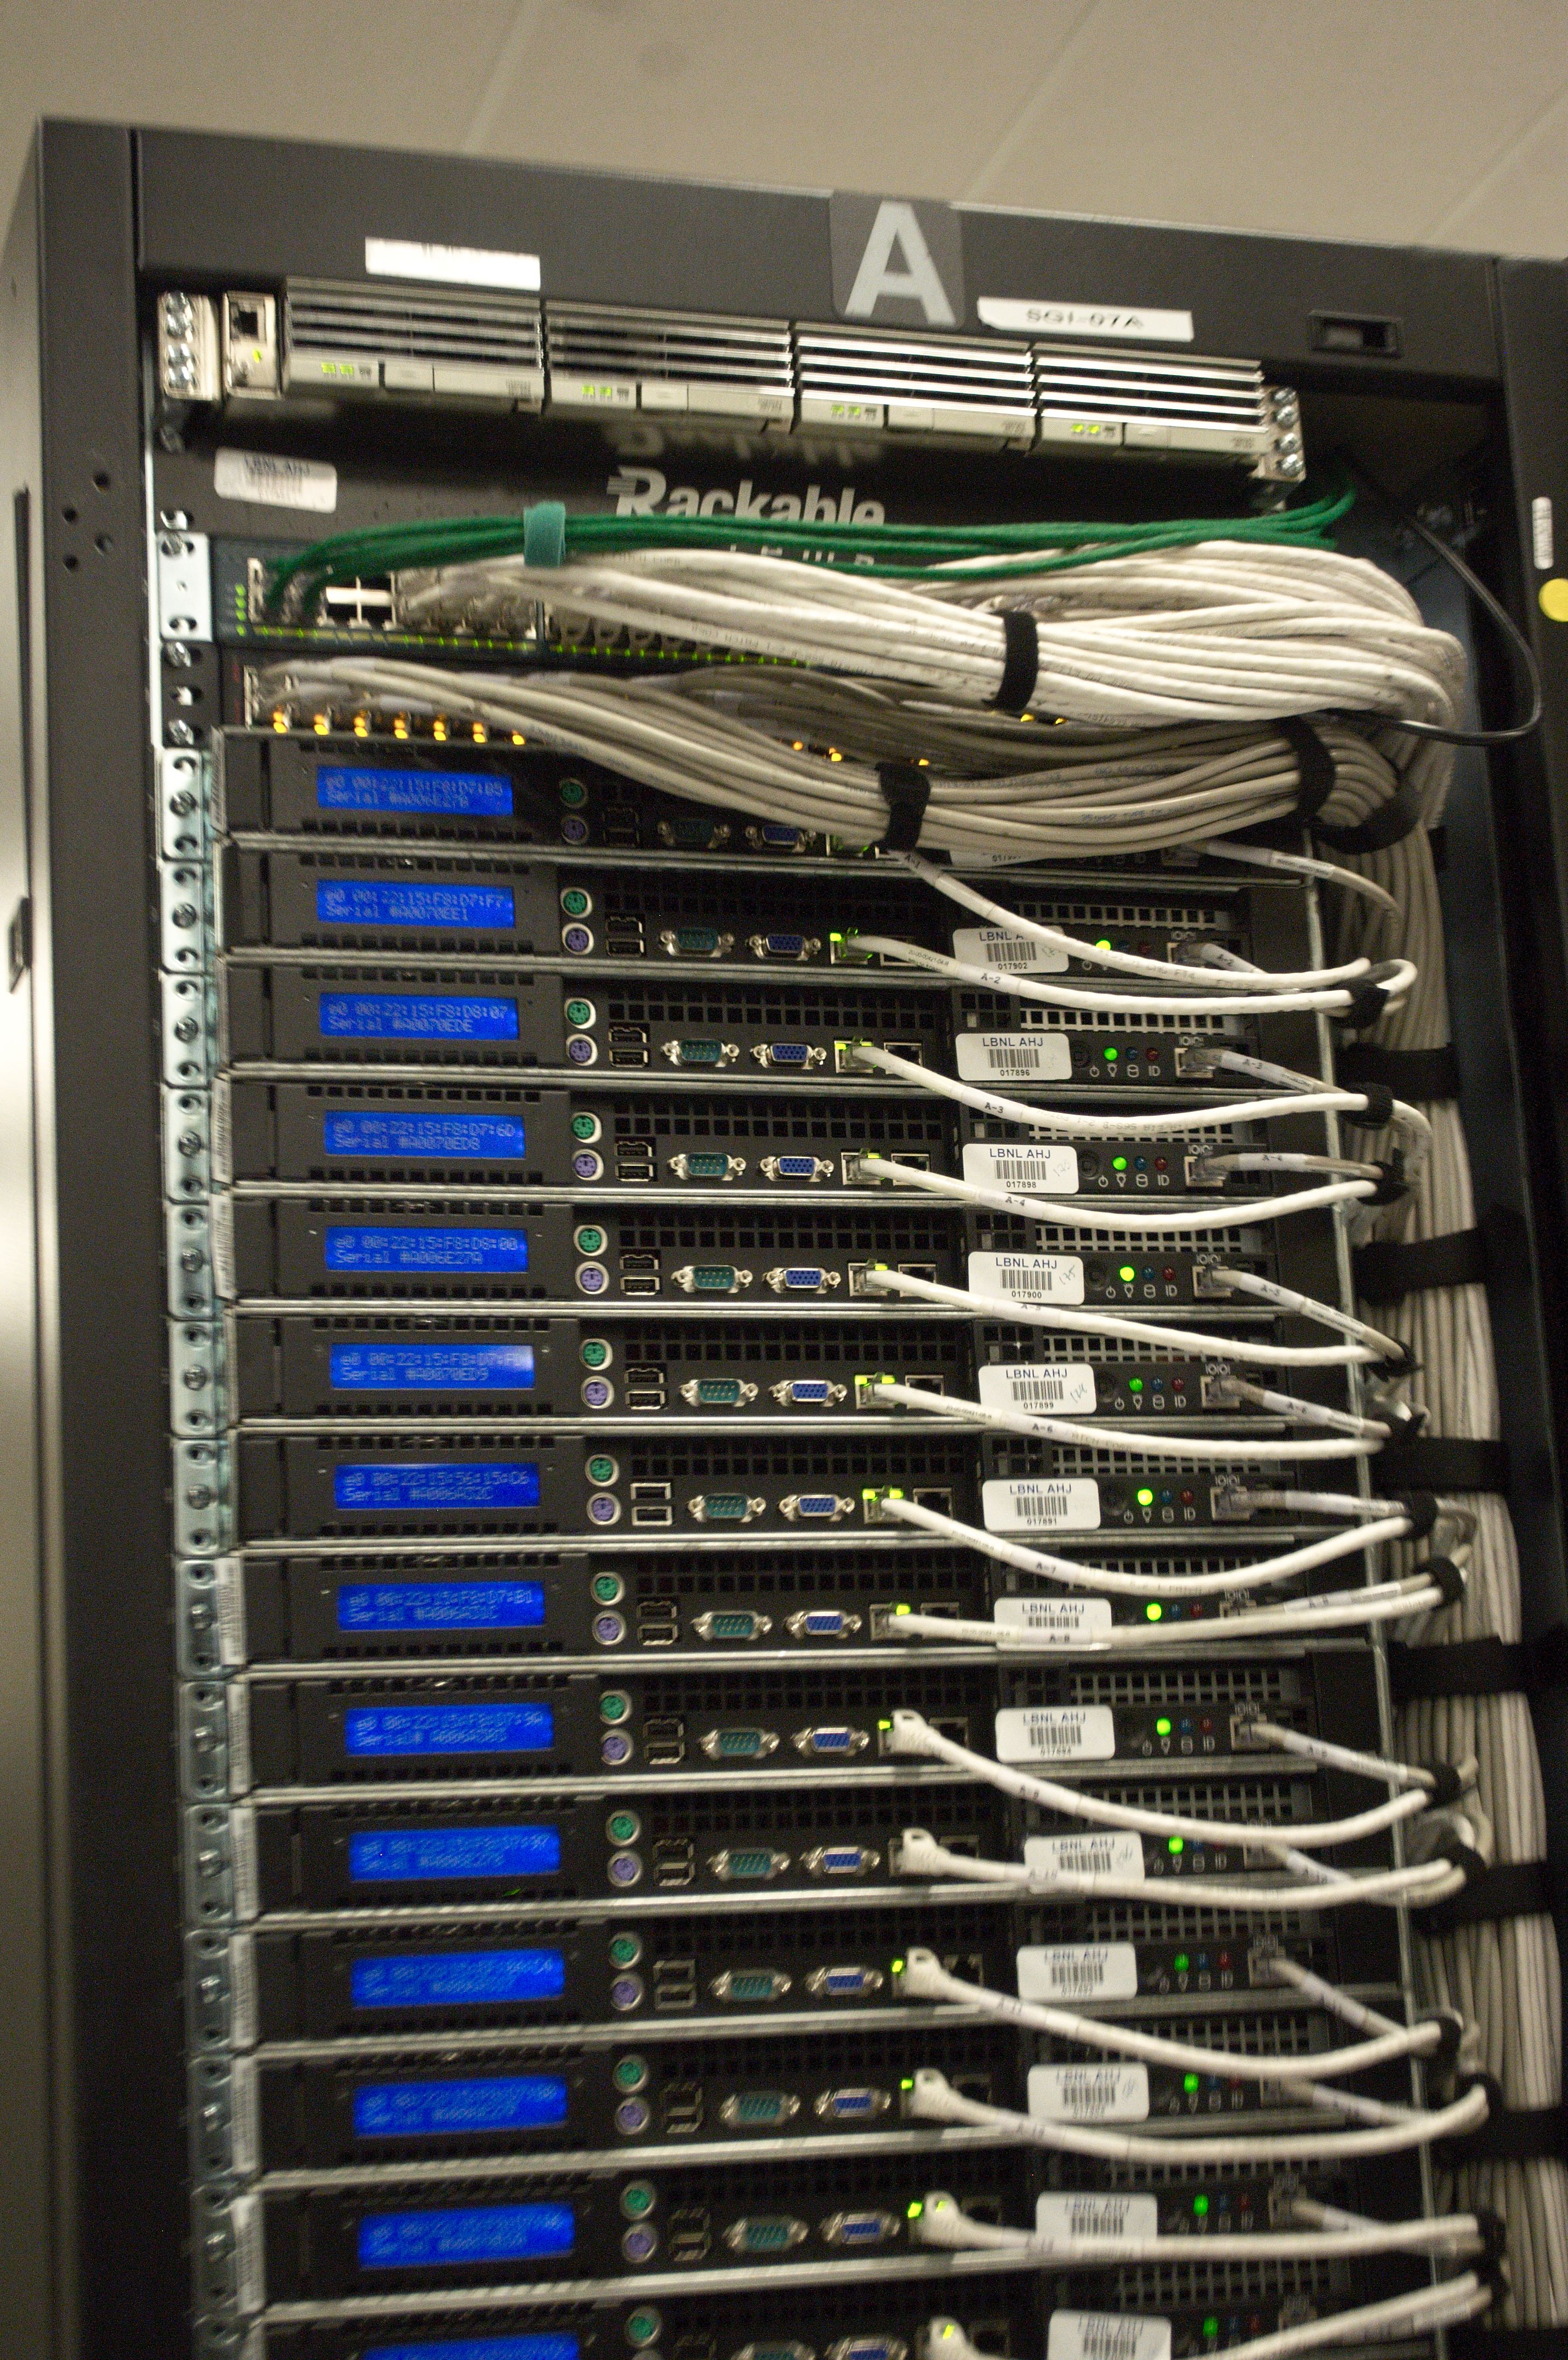
Bildquelle: Picsum.photos (Serverraum, symbolisch für Infrastruktur und Incident Response)
Externe Quellen (in eigenen Worten)
- Google SRE-Blog: Beschreibungen von automatisierten Incident-Response-Ansätzen
- CNCF-Dokumentation: Grundlagen zu Observability-Stacks und Tracing-Integration
- Anthropic Developer-Dokumentation: Hinweise zu Agentic-Workflows und Tool-Use-Patterns