Jahrelang war KI gleichbedeutend mit Cloud: große Modelle, riesige Rechenzentren, teures Inferenz-Backend. Das ändert sich 2026 grundlegend. Edge-AI und On-Device-Modelle reifen technisch schnell, und Unternehmen sowie IT-Teams beginnen, ihre Infrastrukturstrategien entsprechend anzupassen. Dieser Artikel beleuchtet, was hinter dem Trend steckt, welche Hardware ihn trägt und was IT-Verantwortliche jetzt konkret bedenken sollten.
Was ist On-Device-KI?
On-Device-KI bezeichnet die Ausführung von KI-Modellen direkt auf dem Endgerät – einem Smartphone, Laptop, Edge-Server oder Industrieterminal – ohne Verbindung zu einem Cloud-Backend. Die Inferenz, also die Ausführung eines trainierten Modells für eine konkrete Anfrage, findet lokal statt. Das unterscheidet sich grundlegend vom klassischen API-Aufruf an einen Cloud-Provider.
Ermöglicht wird das durch zwei parallele Entwicklungen: Erstens werden die Modelle selbst kleiner und effizienter. Komprimierte Small Language Models (SLMs) mit 1 bis 8 Milliarden Parametern erreichen für viele Aufgaben nahezu die Qualität deutlich größerer Modelle aus früheren Jahren. Zweitens werden Endgeräte mit dedizierten KI-Chips ausgestattet – sogenannten Neural Processing Units (NPUs) –, die Matrixoperationen, wie sie in neuronalen Netzen dominieren, hocheffizient und energiesparend ausführen.
Die Hardware-Entwicklung dahinter
NPUs in Mobilprozessoren
Apple Silicon (M-Serie und A-Serie), Qualcomm Snapdragon 8 Elite sowie MediaTek Dimensity 9400 integrieren alle leistungsstarke NPUs, die Transformer-basierte Modelle mit wenig Watt ausführen können. Apples Neural Engine beispielsweise schafft über 38 TOPS (Tera Operations per Second) bei geringem Energieverbrauch. Das ermöglicht Sprachmodelle mit mehreren Milliarden Parametern direkt auf dem Gerät.
Spezialisierte Edge-Hardware für Unternehmen
Neben Consumer-Geräten gibt es eine wachsende Kategorie von Edge-AI-Servern, die speziell für den Unternehmenseinsatz konzipiert sind. NVIDIA Jetson-Module sowie spezialisierte Inferenz-Appliances adressieren Szenarien, bei denen Cloud-Latenz, Datenschutz oder Netzwerkbandbreite kritisch sind. In der Produktion, in medizinischen Einrichtungen oder bei kritischer Infrastruktur ist Cloud-Inferenz schlicht keine Option – On-Device-KI füllt diese Lücke.
Warum der Trend für IT-Teams relevant ist
Datenschutz und Compliance
Viele Unternehmensanwendungsfälle erfordern, dass sensible Daten das lokale Netzwerk nicht verlassen. Personalakten, medizinische Daten, Finanztransaktionen – bei Cloud-Inferenz werden diese Daten zwangsläufig an externe Server übertragen. On-Device-Modelle verarbeiten diese Daten lokal und minimieren damit das Datenschutzrisiko erheblich. Besonders unter der DSGVO und dem EU AI Act ein zunehmend wichtiges Argument.
Latenz und Offline-Verfügbarkeit
Für Echtzeitanwendungen sind Cloud-Roundtrips oft zu langsam. Spracherkennung in Produktionsanlagen, autonome Qualitätskontrolle in der Fertigung oder KI-gestütztes Routing auf Netzwerk-Appliances profitieren von Inferenzzeiten unter 10 ms, die nur lokal erreichbar sind. Zudem funktionieren On-Device-Modelle auch ohne Netzwerkverbindung – für kritische Infrastruktur kein Luxus, sondern Anforderung.
Betriebskosten
Cloud-API-Kosten für häufige, kleine Anfragen summieren sich schnell. On-Device-Inferenz hat nach einem einmaligen Hardware-Investment keine variablen Betriebskosten mehr. Für Unternehmen mit vorhersehbaren, hochfrequenten Nutzungsmustern kann sich das schon innerhalb eines Jahres rechnen. Die Kalkulation wird attraktiver, je stärker die Nutzung wächst.
Aktuelle Modelle für On-Device-Deployment
- Llama 3.2 (1B/3B): Metas kompakte Llama-Varianten sind speziell für mobile und Edge-Deployment optimiert. Die quantisierten Versionen laufen flüssig auf modernen Smartphones und Edge-Servern.
- Mistral 7B / Mistral Small: Mistral AIs kompakte Modelle liefern starke Leistung bei geringem Footprint und sind für lokales Deployment in der IT-Community weit verbreitet.
- Phi-4 Mini (Microsoft): Microsofts Phi-Reihe ist gezielt für Effizienz optimiert und eignet sich für Unternehmensgeräte mit begrenzter Hardware – besonders für Textverarbeitung und Code-Assistenz.
- Gemma 2 (Google): Googles Open-Source-Modell in 2B und 9B Variante, verfügbar über Google AI Edge für mobile und Edge-Integration.
- Apple Intelligence-Modelle: Apples eigene Modelle laufen direkt auf Apple Silicon mit Private Cloud Compute als Fallback – ein hybrides On-Device-First-Konzept, das als Industriestandard Schule machen könnte.
Tools und Frameworks für das Deployment
Für IT-Teams, die On-Device-KI evaluieren oder deployen möchten, gibt es heute ein ausgereiftes Ökosystem. Ollama ist das Standardwerkzeug für lokale LLMs unter Linux, macOS und Windows – einfach installiert, OpenAI-kompatible API inklusive. LM Studio bietet eine grafische Oberfläche und eignet sich für erste Evaluierungen ohne tiefere Kommandozeilenkenntnisse.
Für produktive Deployments auf ARM- und x86-Edge-Hardware sind llama.cpp (C++ Inferenz-Engine) und ONNX Runtime die etablierten Lösungen. Sie ermöglichen quantisierte Inferenz auch auf Hardware ohne dedizierte GPU. Im Enterprise-Kontext erlauben Plattformen wie NVIDIA AI Enterprise das Management von On-Device-Modellen in größerem Maßstab mit Versionierung, Monitoring und Rollout-Steuerung.
Hybride Strategien: On-Device und Cloud kombinieren
Praktisch setzen die meisten IT-Teams nicht auf ein Entweder-oder, sondern auf eine hybride Architektur. Einfache, häufige Anfragen werden lokal bearbeitet – schneller, billiger, datenschutzkonform. Komplexe Anfragen, die mehr Reasoning erfordern, werden an Cloud-APIs weitergeleitet. Diese Routing-Logik kann selbst KI-gestützt sein: Ein kleines lokales Modell entscheidet, ob eine Anfrage lokal beantwortet werden kann oder eskaliert werden muss.
Für FreshCore-Nutzer bedeutet das konkret: Monitoring-Daten und Alerting-Logik könnten lokal vorverarbeitet werden, bevor relevante Ereignisse an zentrale Systeme weitergeleitet werden. Das reduziert Latenz bei kritischen Alerts und minimiert die Datenmenge, die externe Dienste verarbeiten müssen.
Was IT-Teams jetzt tun sollten
- Hardware-Inventar prüfen: Welche Geräte haben NPUs? Viele neue Laptops der Mitarbeiter sind bereits Edge-AI-fähig, ohne dass IT das aktiv nutzt.
- Datenschutzanforderungen auflisten: Welche Anwendungsfälle sind aus Datenschutzgründen nicht cloud-tauglich? Das sind primäre Kandidaten für On-Device-Deployment.
- Testbed aufsetzen: Ollama auf einem Linux-Server, ein Mistral-7B-Modell, und ausgewählte interne Anfragen testen. Latenz und Qualität selbst messen, statt auf Herstellerangaben zu vertrauen.
- Betriebskosten modellieren: Aktuelle monatliche Cloud-API-Kosten gegen Einmalkosten für lokale Hardware gegenrechnen. Die Break-even-Schwelle ist oft überraschend niedrig.
On-Device-KI ist kein Nischenthema mehr – sie ist ein strategischer Baustein für resilienz- und datenschutzorientierte IT-Architekturen. Teams, die heute evaluieren, haben in einem Jahr einen erheblichen Erfahrungsvorsprung gegenüber Organisationen, die weiter ausschließlich auf Cloud-KI setzen.
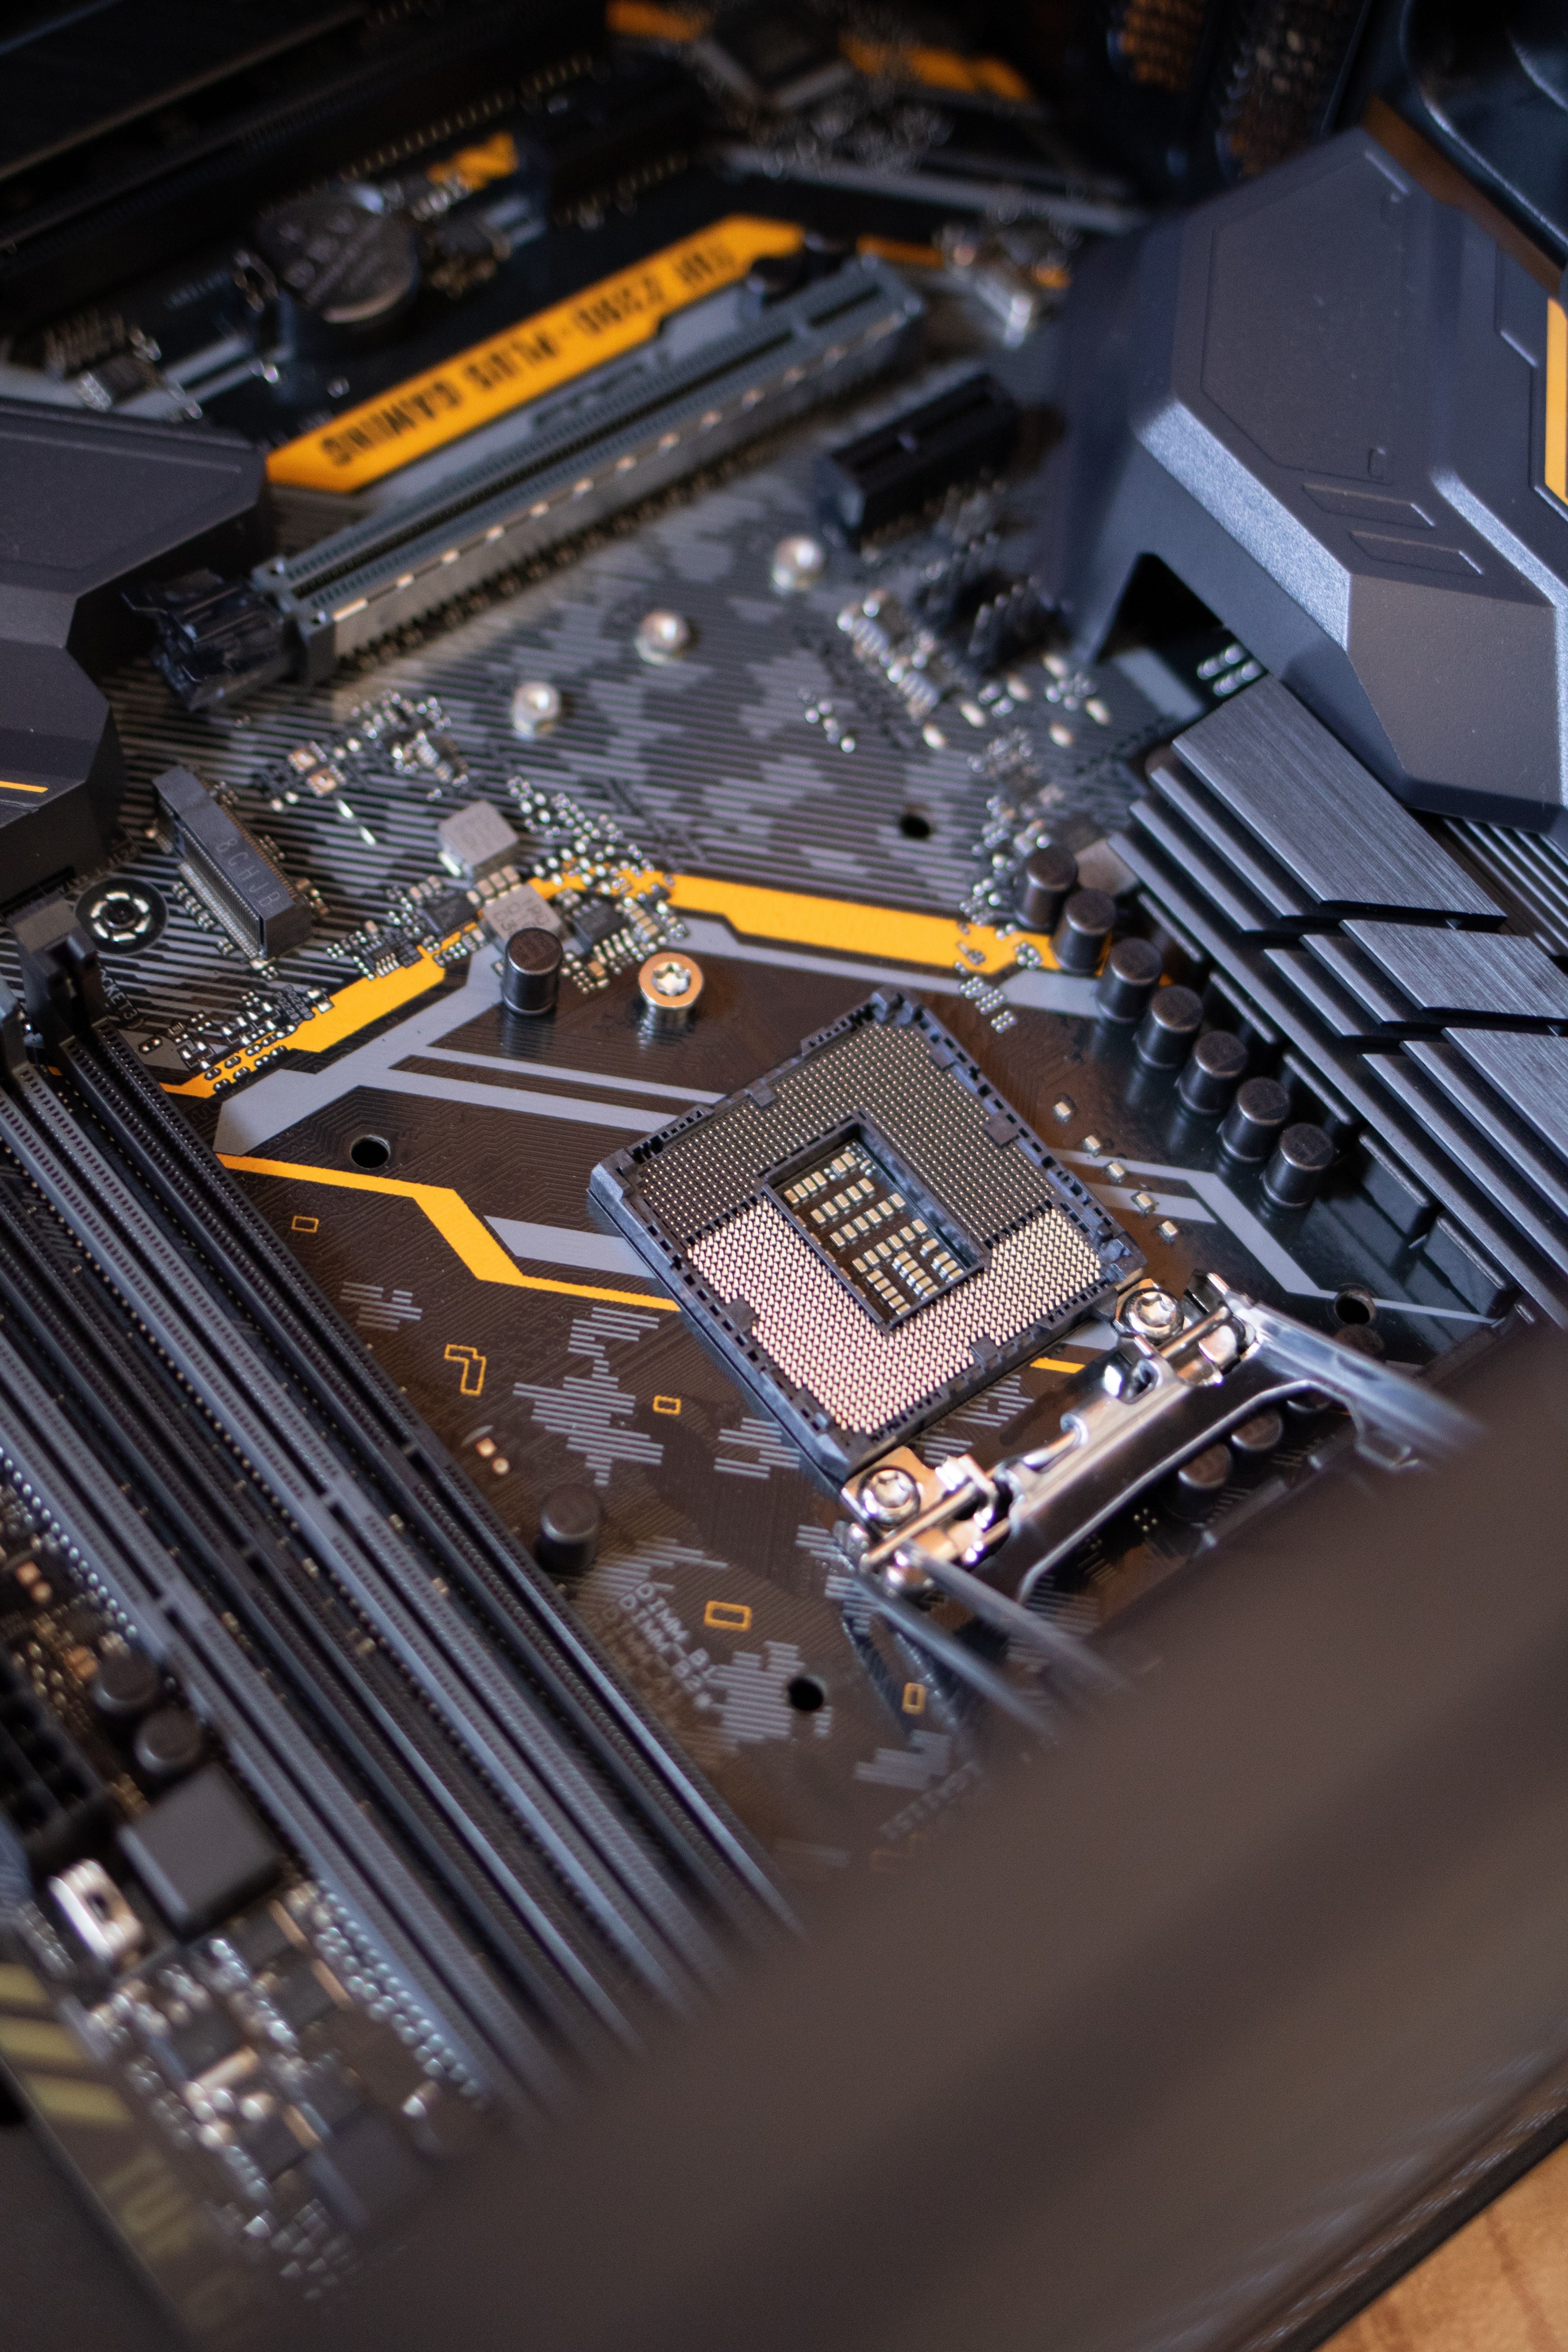
Bildquelle: Pexels (pexels.com/photo/2582937)
Quellen
- Qualcomm: Snapdragon 8 Elite Technical Overview, qualcomm.com
- Apple: Neural Engine Documentation, developer.apple.com
- Meta AI: Llama 3.2 Release Notes, ai.meta.com
- Ollama Dokumentation, ollama.com
- Microsoft Research: Phi-4 Technical Report, microsoft.com